
硅基流动上线高速版 GLM-5.3-Flash
前沿 多模态 智能,变得更加“随手可用”。作为智谱 GLM-5 系列首款原生多模态模型, GLM-5.3-Flash 不仅显著提升了编程能力与推理效率,还解锁了视觉理解能力。
在 Artificial Analysis 综合智能指数测试中,GLM-5.3-Flash 取得 42 分,与 Claude Opus 4.8 (max) 持平;在智谱自研 Z.ai Code Bench 体感评估中,编程表现也与其相当。与此同时,GLM-5.3-Flash 具备更低的定价,让开发者能轻松将前沿智能转化为真实生产力。
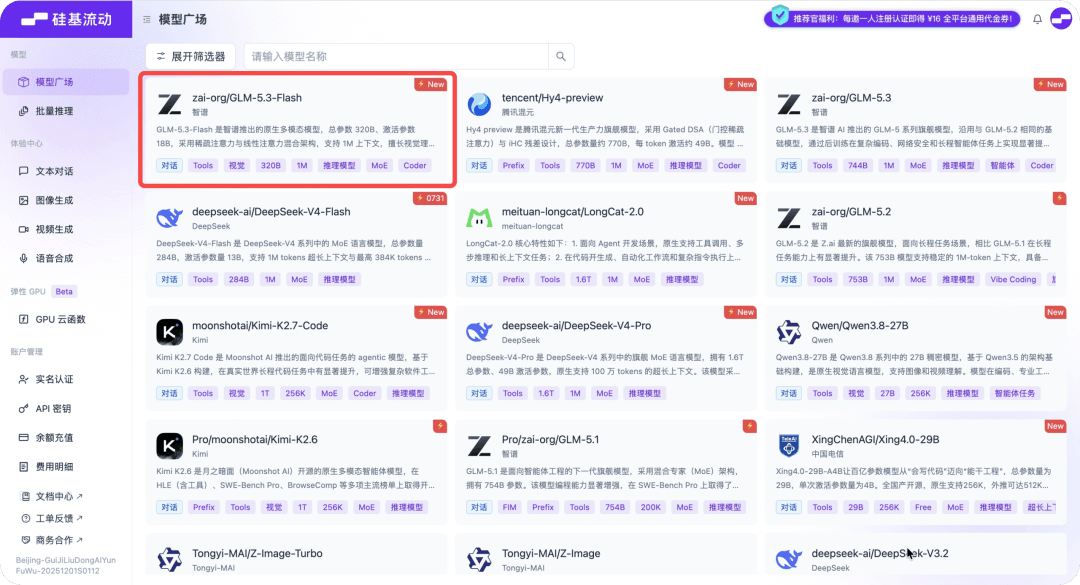
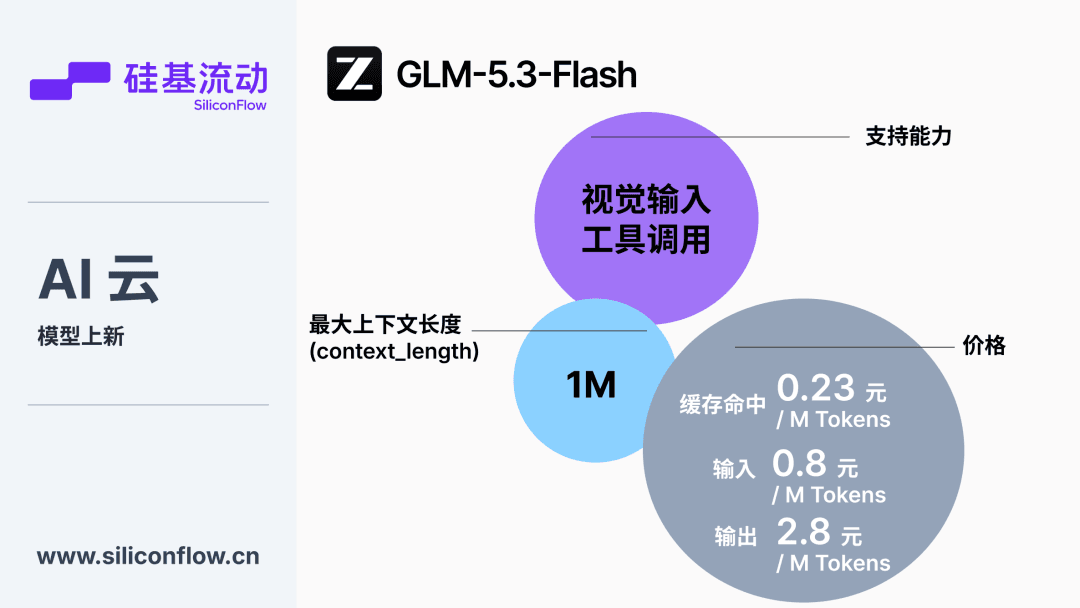
GLM-5.3-Flash 围绕能力与效率重新设计了架构与训练方案。GLM 系列首次融合稀疏注意力和线性注意力机制,在支持 1M 长上下文精确处理的基础上,显著降低了推理成本;同时引入流形约束超连接技术,并基于最新的 30T-token 多模态预训练语料进行训练。这些优化使 GLM-5.3-Flash 能以更少的计算资源,实现更强大的智能表现。
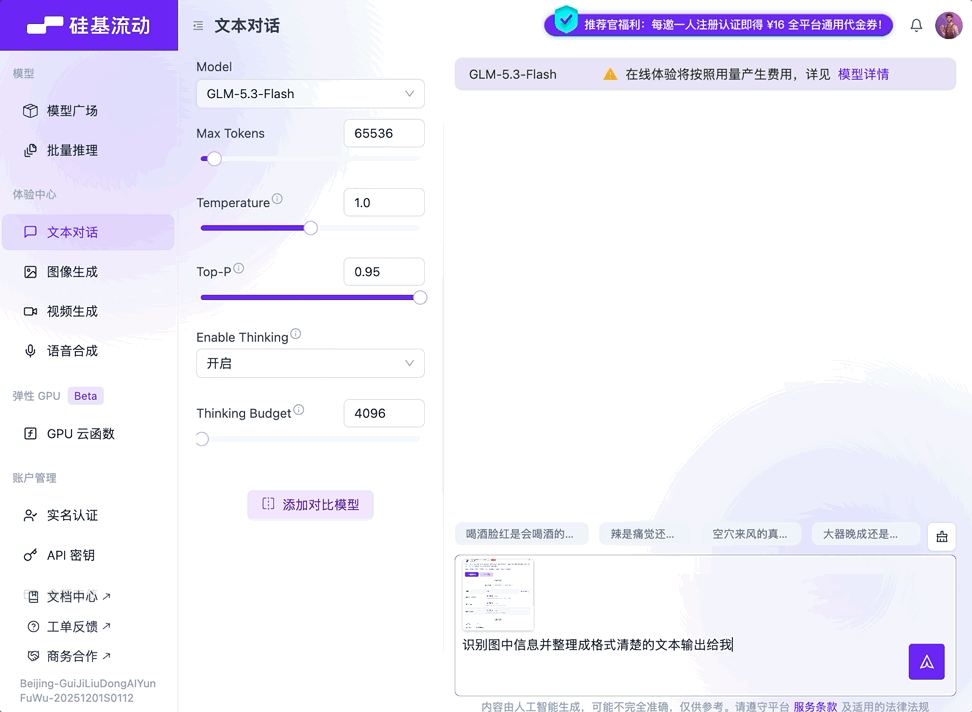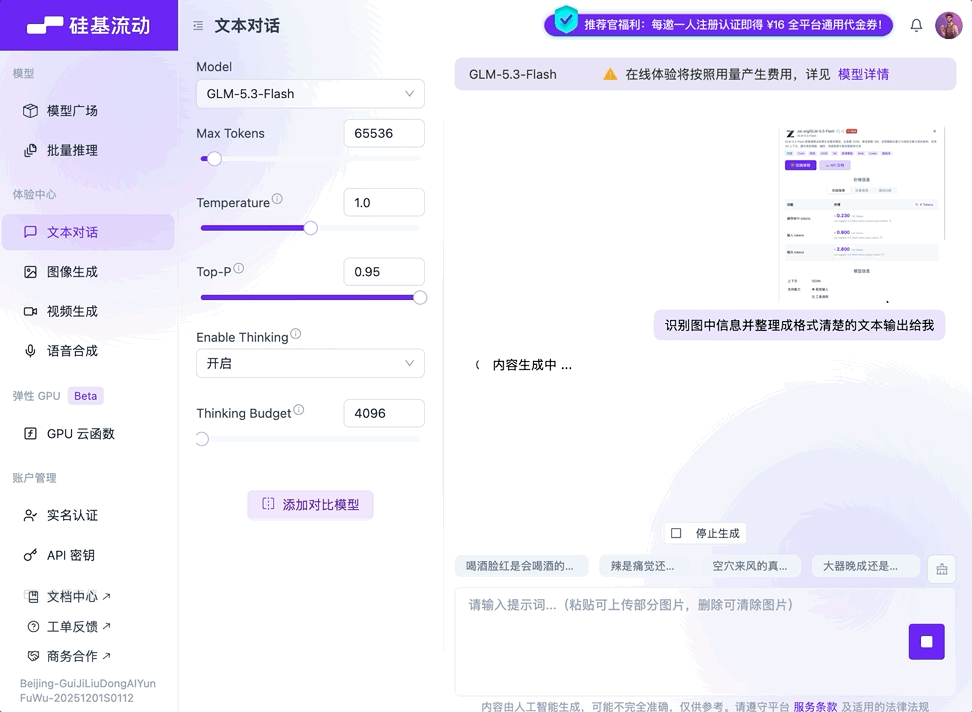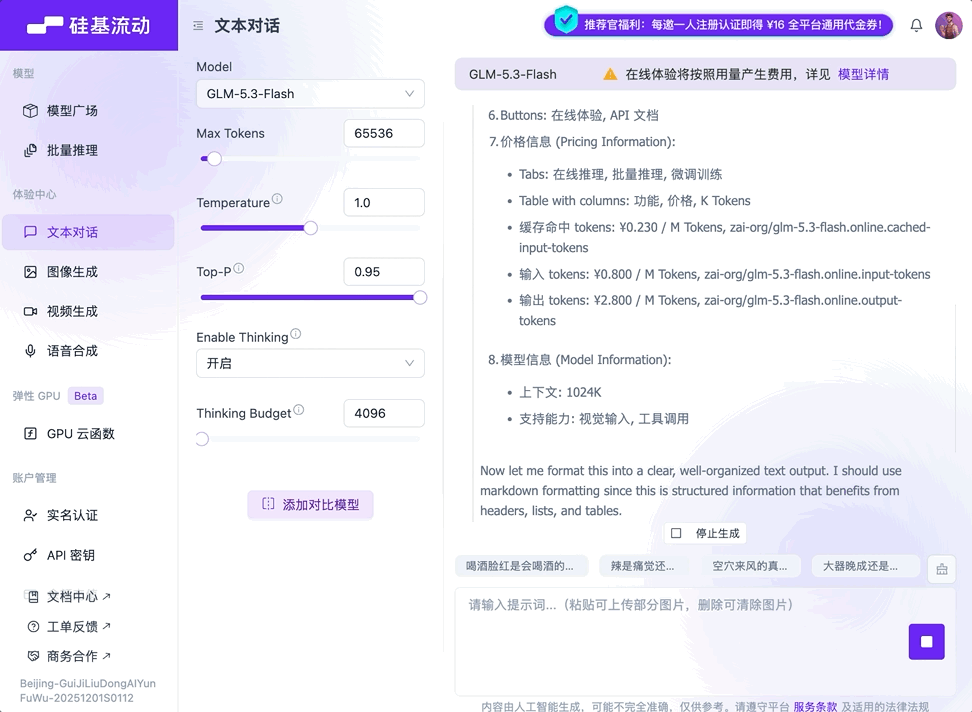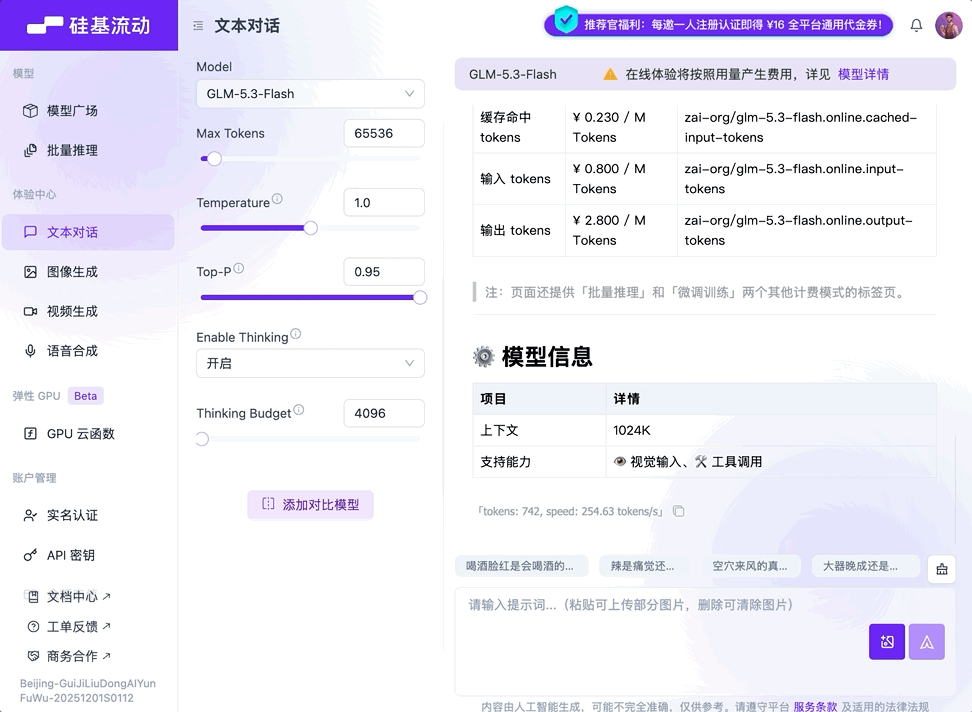
它的视觉编程能力并不止于“看懂”素材,它更补全了 Agent 工作流中关键的视觉判断与反馈闭环。从前端、游戏、3D 开发到日常办公场景,GLM-5.3-Flash 能在生成代码的同时,自主进行视觉验证与迭代优化,从而提升交付质量。
在 Agent 环境中,我们给 GLM-5.3-Flash 提供了一张相机参考图,让模型从零构建一个可交互、可拆解的 3D 相机模型。在整个过程中,GLM-5.3-Flash 不仅能对参考图片进行视觉解析,生成对应代码,还在测试阶段根据视觉反馈优化细节,检查并调整文字、标签等元素的渲染效果。最终,模型交付的 3D 相机还原了参考图中的大致外观,也实现了按键交互、相册浏览、一键分层拆解与重组等功能,让用户既能上手操作,也能直观查看各部分的结构。
最值得一提的是,GLM-5.3-Flash 让开发者在享受前沿智能时,无需再为成本担忧。在 硅基流动 AI 云,GLM-5.3-Flash 的调用价格为:缓存命中 0.23 元 / M tokens,输入 0.8 元 / M tokens,输出 2.8 元 / M tokens。
现在,WorkBuddy、Claude Code、 Codex 、CodeBuddy、Cursor、TRAE、OpenCode、Cline、Hermes Agent 等主流工具均可接入硅基流动 API,你可直接调用 GLM-5.3-Flash,高效、低成本地处理代码工程与多模态 Agent 任务。
硅基流动致力于成为用户首选的“Token 工厂”,提供 大模型 云服务、专属实例及AI 算力运营服务。大模型云服务提供多样、高速、稳定且经济的模型 API,已上架 Qwen 、GLM、DeepSeek、Kimi 等百款热门模型,覆盖语言、图像、音频、视频、嵌入与重排序全任务场景。仅需一个密钥,即可灵活调用,助开发者加速构建生成式 AI 应用。新用户可获得 16 元 / 1 美元赠金体验平台所有模型。多款模型免费,让开发者实现“Token 自由”。
国内站:cloud.siliconflow.cn/models
国际站:cloud.siliconflow.com/models