
数据只经过,不落脚:拆解硅基流动 API 的数据流转链路
“你们平台存我的数据吗?”
企业评估和接入大模型 API 时,几乎绕不开这个问题。但市面上的回答大多不够清楚:服务协议对数据安全的约定含糊不清;“不用于模型训练”的承诺背后,仍留存交互数据用于意图分析、质量评估甚至商业洞察。
本文将重点拆解硅基流动大模型 API 的数据流转链路,分析如何保障用户交互数据“只经过,不落脚”。
协议层:把不留存数据的承诺写成条款
硅基流动在《隐私政策》和《平台使用协议》明确:除 IP 地址、调用的模型名称、Token 消耗量、请求时间及请求状态码等运维原数据,交互数据完全归用户所有,平台不会对其进行任何非授权的使用或披露,亦不会进行任何存储。
针对大模型 API 加速推理服务,隐私政策写明:
针对大模型API加速推理服务,我们仅作为底层算力与技术提供方。对于您通过API传输的业务数据(包括输入指令及生成的输出内容),我们仅在提供当次推理计算的必要且短暂的时间内进行处理。我们不会长期存储您的任何业务输入与输出数据;不会将您的业务数据用于任何大模型的预训练、微调或其他商业用途;推理计算完成后,相关业务数据将立即从我们的计算节点中销毁或不可恢复。同时,如您作为开发者或企业客户使用我们的API服务向最终用户提供服务,您应当确保您输入的数据来源合法,并已依法获取最终用户的充分授权同意。
技术层:一条没有磁盘节点的数据链路
协议约束的是承诺。在硅基流动的数据流转链路里,也没有设计和挂载持久化存储的接口。
下图是硅基流动大模型服务的数据流图。从你在客户端发起请求到结果返回,数据主要流经三个区域,像一个进入高保密流水线的包裹,全程不落入任何磁盘。
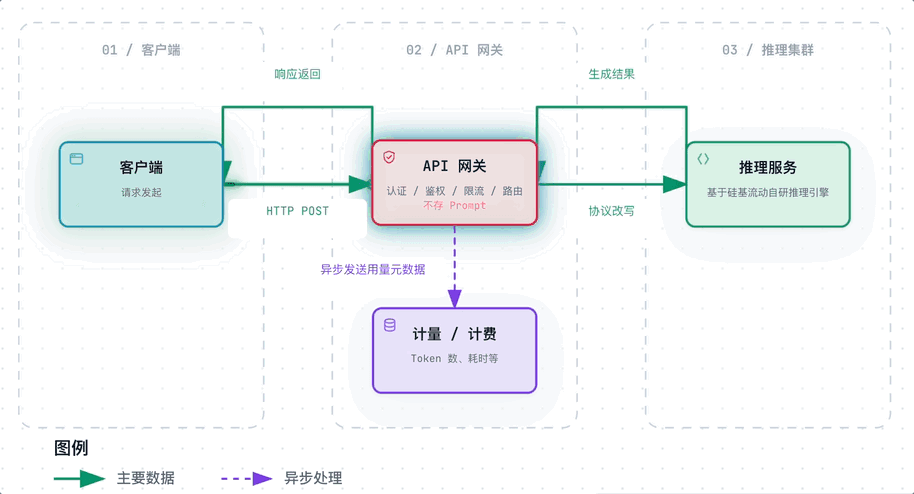
第一区,客户端。
你在应用中输入提示词,对话历史均由客户端自己保存,每次随请求以 HTTP POST(包含 Prompt 和模型参数)发往硅基流动 API。此时数据在客户端内存中,推理服务平台尚未接触。
第二区,API 网关。
请求到达 API 网关后,依次完成认证、鉴权、限流和路由。这里只核对调用方的身份及相应权限,处理完鉴权信息立刻释放内存,不会保存提示词内容。随后,网关会对请求进行协议改写(比如加上内部路由标签),并无状态地分发给后方的推理集群。同时,网关会异步发送 Token 消耗数、耗时等用量元数据至旁路计费系统,计费系统完全不接触交互内容。
第三区,推理集群。
数据进入推理集群,交由硅基流动自研推理引擎驱动的推理服务处理。引擎在底层自动完成输入处理和 Token 生成,这期间产生的 KV Cache(上下文缓存)以及所有中间计算状态,都只在 GPU 显存中流转。推理一旦完成,显存随资源释放而清空,不会向任何磁盘写入。
最后,生成的响应数据经 API 网关回到你的客户端。
走完三大区链路,事实非常简单:你的提示词和模型输出,在磁盘上的写入量为 0。在架构上,我们没有为交互数据准备任何存储层。
企业的选择
对企业而言,大模型服务的选择,需要同时考虑能力、效率、成本与数据安全。尤其在金融、能源、电力、医疗、汽车制造等行业,业务数据敏感、系统运行要求严格,安全合规与自主可控是大模型服务进入实际业务的重要前提。
目前,硅基流动已提供无服务器词元服务、专属实例、本地部署解决方案的等重点产品、服务超 10000 个用户,13000 余家企业客户。大模型厂商、互联网、头部证券机构、能源和电力央企等都已在各自的业务中采用硅基流动的产品与服务,支持大模型从场景试点走向应用。企业的需求各有不同,对服务的考察也贯穿部署、接入和持续运行的全过程。这些合作实践,为关注数据安全与业务可控的企业提供了具体的标杆案例选型参考。
回到开头那句“你们平台存我的数据吗?”我们的回答是:协议里写明不留存交互数据,数据流转路径上不设计、不挂载持久化存储的接口。
在硅基流动,你的数据只经过,不落脚。